实时 I/O(RTIO)
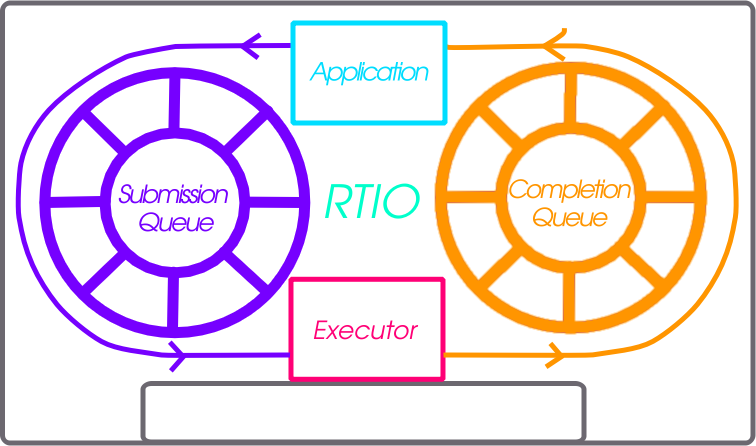
RTIO 提供了一个使用事件驱动 I/O 构建异步操作链的框架。本节介绍 RTIO API、队列、执行器、iodev,以及与外围设备配合使用时常见的用法模式。
RTIO 在操作方式和 API 上大量借鉴了 Linux 的 io_uring,因为该 API 与硬件传输队列及描述(例如 DMA 传输列表)十分契合。
问题
如今,希望在 Zephyr 中实现复杂的 DMA 或中断驱动操作的应用,必须直接了解硬件及其工作方式。DMA API 并不理解其他 Zephyr 设备及其相互之间的关系。
这意味着要实现复杂的音频、视频或传感器流式传输,就必须具备直接的硬件知识,或者依赖对 DMA 控制器做泄漏抽象的设计。这两者都不理想。
为了支持异步操作(尤其是使用 DMA 的场景),需要一种对要做什么的描述,而不是通过 C 代码和回调直接执行操作。要启用 DMA 的通道优先级、传输序列等特性,仅仅一份简单的描述列表是不够的。
使用 DMA 和/或中断驱动的 I/O 不应决定该调用是否阻塞。
灵感来源:引入 io_uring
最好不要重新发明轮子(这里指环形队列),来自 Linux 内核的 io_uring API 提供了一个很好的模型。在 io_uring 中,有两个无锁环形缓冲区充当内核与用户态应用之间共享的队列:一个队列用于提交项,这些提交项可以串联并刷新,以创建并发的顺序请求;另一个队列用于完成队列事件。实际上只需一次系统调用(io_uring_submit)即可执行多个操作。当给出需要等待的操作数量时,该调用可能会阻塞调用者。
这种模型非常适合 DMA 和中断驱动的传输。以异步方式执行一系列操作的请求,与硬件典型的工作方式直接对应,即由中断驱动的状态机来实现,并且可能涉及总线和 DMA 控制器等多个外设 IP。
提交队列
提交队列(submission queue,sq)描述要并发串联执行的操作。
例如,设想一次典型的 SPI 传输:先写入寄存器地址,然后读取数据。操作序列可能是……
片选
时钟使能
把寄存器地址写入 SPI 发送寄存器
从 SPI 接收寄存器读入缓冲区
关闭时钟
取消片选
如果这条操作链中任何一步失败就放弃。其中一些操作可以体现在某个设备抽象中,该抽象理解读或写隐含地意味着要设置时钟和片选。请求的事务性也需要以某种方式体现。在上述操作中,读取可能因为数据量足够大而适合用 DMA 完成,这需要了解如何配置该设备特定的 DMA。
上述操作序列在 RTIO 中体现为提交队列项(submission queue entry,sqe)链。串联的方式是在某个 sqe 中设置一个标志位,表示下一个 sqe 必须等待当前 sqe 完成。
由于片选和时钟控制对总线上的特定 SPI 控制器和设备是共用的,它们体现在 RTIO 所称的 iodev 中。
针对同一个 iodev 的多个操作会尽快按给定顺序执行。如果两条操作链在不同位置使用同一个设备,其中一条链可能必须等待另一条完成。
完成队列
为了知道某个 sqe 何时完成,RTIO 提供了完成队列(completion queue,cq)及其完成队列事件(completion queue event,cqe)。sqe 完成后会把一个 cqe 推入 cq。cqe 的顺序可能与 sqe 的顺序不同。不过,sqe 链能够保证顺序和失败级联。
还可以采用其他方案,但完成队列在 io_uring 及其他类似的操作系统 API 中已是经过充分验证的做法。
执行器
RTIO 执行器是一个低开销的并发 I/O 任务调度器。它确保某些请求标志能带来预期的行为。它接收一个提交列表并按顺序处理。各种标志可以改变提交的处理方式:可以把提交组成有序链、组成事务式提交集合,或者创建多次触发(持续产生)的请求!
IO 设备
把提交队列项(sqe)转换为完成队列事件(cqe)是实现 iodev(IO 设备)API 的对象的职责。该 API 以 iodev 提交 API 调用的形式接受请求。IO 设备负责处理其内部提交队列并把它们转换为完成事件。实际上,每个 IO 设备都可以看作一个独立的、事件驱动的类似 actor 的对象,它接受永不结束的类 I/O 请求队列。iodev 如何完成这些工作由 iodev 的作者决定,也许整个操作队列都可以转换为一组 DMA 传输描述符,这意味着硬件几乎承担了全部实际工作。
取消操作
取消一个已排队的操作是可能的,但并不保证成功。如果该 SQE 尚未开始执行,调用 rtio_sqe_cancel() 很可能将其移除并使其永远不执行。但如果该 SQE 已经开始执行,取消请求将被忽略。
内存池
在某些情况下,读取请求可能不知道会产生多少数据。或者,读取方可能要处理来自多个 IO 设备的数据,而数据产生的频率不可预测。在这些情况下,把内存绑定到进行中的读请求可能造成浪费。改用内存池时,读入所用的内存交由 iodev 从与该读操作所属 RTIO 上下文关联的内存池中分配。要创建这样的 RTIO 上下文,可以使用 RTIO_DEFINE_WITH_MEMPOOL。它允许创建一个 RTIO 上下文并为其指定专用的“内存块”池,供 iodev 使用。下面是一段使用内存池设置 RTIO 上下文的代码片段。该内存池有 128 个块,每个块大小为 16 字节,数据按 4 字节对齐。
#include <zephyr/rtio/rtio.h>

#define SQ_SIZE       4
#define CQ_SIZE       4
#define MEM_BLK_COUNT 128
#define MEM_BLK_SIZE  16
#define MEM_BLK_ALIGN 4

RTIO_DEFINE_WITH_MEMPOOL(rtio_context,
    SQ_SIZE, CQ_SIZE, MEM_BLK_COUNT, MEM_BLK_SIZE, MEM_BLK_ALIGN);
需要进行读取时,调用者只需把 rtio_sqe_prep_read() 调用(它接收缓冲区指针和长度)替换为 rtio_sqe_prep_read_with_pool() 调用。iodev 只需做少量改动,即可同时支持预先分配的数据缓冲区以及内存池。当读取就绪时,iodev 不应直接从 rtio_iodev_sqe 获取缓冲区,而应像下面这样调用 rtio_sqe_rx_buf() 来获取缓冲区和计数:
uint8_t *buf;
uint32_t buf_len;
int rc = rtio_sqe_rx_buff(iodev_sqe, MIN_BUF_LEN, DESIRED_BUF_LEN, &buf, &buf_len);

if (rc != 0) {
  LOG_ERR("Failed to get buffer of at least %u bytes", MIN_BUF_LEN);
  return;
}
最后,使用者可以通过 rtio_cqe_get_mempool_buffer() 访问所分配的缓冲区。
uint8_t *buf;
uint32_t buf_len;
int rc = rtio_cqe_get_mempool_buffer(&rtio_context, &cqe, &buf, &buf_len);

if (rc != 0) {
  LOG_ERR("Failed to get mempool buffer");
  return rc;
}

/* Release the cqe events (note that the buffer is not released yet */
rtio_cqe_release_all(&rtio_context);

/* Do something with the memory */

/* Release the mempool buffer */
rtio_release_buffer(&rtio_context, buf);
适用场景
RTIO 适用于需要并发或批量式 I/O 流程的场景。
从驱动或硬件的角度看,该 API 支持把 I/O 请求批量提交,并可能以最优方式完成。例如,针对同一个 SPI 外设的大量请求可以完全转换为硬件命令队列或 DMA 传输描述符。这意味着硬件能够发挥出比以往更大的作用。
每个 RTIO 上下文和 iodev 都有少量开销。可以把这一开销与为每个并发 I/O 操作使用一个线程,或为每个外设使用自定义队列和线程的做法进行比较。RTIO 的开销要低得多。
支持的总线
要检查你的总线是否原生支持 RTIO,可以查看驱动 API 的实现:如果驱动实现了总线 API 的 iodev_submit 函数,就说明支持 RTIO。如果驱动不支持 RTIO API,它会把 submit 函数设置为 i2c_iodev_submit_fallback。
I2C 总线有一个默认实现,允许应用在厂商实现 submit 函数之前先利用 RTIO 工作队列。借助该队列,任何未实现 iodev_submit 函数的 I2C 总线驱动都会改为交给一个工作项,由该工作项执行阻塞式 I2C 事务。要更改池大小,请为 CONFIG_RTIO_WORKQ_POOL_ITEMS 设置不同的值。