对称多处理
在多处理器架构上,Zephyr 支持使用多个物理 CPU 运行 Zephyr 应用程序代码。这种支持是“对称”的,因为默认情况下不会特殊对待任何 CPU。任何处理器都能够运行任意 Zephyr 线程,并可访问所有受支持的标准 Zephyr API。
无需编写特殊的应用程序代码即可使用此功能。如果受支持的双处理器设备上有两个可运行的 Zephyr 应用线程,它们就会同时运行。
SMP 配置由 Kconfig 变量 CONFIG_SMP 控制。必须将其设为“y”才能启用 SMP 功能,否则会构建单处理器内核。通常,支持此功能的平台都会默认启用它。启用后,构建时可通过 CONFIG_MP_MAX_NUM_CPUS 查看可用物理 CPU 的数量。同样,此选项默认值为平台上的可用 CPU 数量,典型应用程序通常不应修改。不过,为测试或为非 Zephyr 代码预留物理 CPU 等特殊用途,将其设置为更小(显然不能更大)的值是合法且受支持的。
同步
在应用程序层面,Zephyr 核心 IPC 和同步原语在 SMP 内核中的行为完全相同。例如,使用信号量实现阻塞式互斥,仍然是合适的应用程序设计选择。
但在最底层,Zephyr 代码过去经常使用 irq_lock()/irq_unlock() 原语,通过屏蔽中断实现细粒度临界区。这些 API 通过模拟层仍可正常工作(见下文),但单纯屏蔽中断的方法并不奏效:在临界区内,你的 CPU 不会被中断,并不意味着另一个 CPU 不会同时运行并检查或修改同一份数据!
自旋锁
SMP 系统提供了约束更严格的 k_spin_lock() 原语。它像 irq_lock() 一样屏蔽本地中断,同时以原子方式保护一个共享锁变量,确保任意时刻只有一个 CPU 进入临界区。与传统 IRQ 锁不同,自旋锁彼此独立,且不能递归获取。完整说明(包括票号自旋锁和 API 参考)参见 自旋锁。
传统 irq_lock() 模拟
为兼容使用单处理器锁定 API 编写的应用程序,irq_lock() 和 irq_unlock() 在 SMP 系统上仍保持与原有版本相同的语义。它们通过一个带嵌套计数的全局自旋锁实现,并可在上下文切换到持锁线程时以原子方式重新获取。内核保证所有 CPU 上任意时刻只有一个线程能够持有该锁,在上下文切换时释放它,并在线程切入时按需重新获取,以恢复锁状态。其他 CPU 会自旋等待该锁释放。
不过,此过程的开销会产生可测量的性能影响。与单处理器应用程序不同,SMP 应用程序使用 irq_lock() 时,执行的不再只是一个很短(通常约为一条指令)的中断屏蔽操作。再加上 IRQ 锁是全局的,因此预期在 SMP 环境中运行的代码应尽可能使用自旋锁 API。
内存一致性
某些多处理器架构 不具备缓存一致性:各 CPU 的缓存不会自动保持一致,因此一个 CPU 写入的数据,可能只有从缓存写回后才对另一个 CPU 可见。在这类系统上,共享内核数据结构必须位于所有 CPU 都能一致观察到的内存中。
启用 CONFIG_KERNEL_COHERENCE 后,内核会将所有共享数据放入具备多处理器一致性的内存(通常是不缓存的内存)。线程栈仍使用缓存,显式声明为 __incoherent 的应用程序内存也一样。此模式仅用于运行在非缓存一致性架构上的 SMP 内核,并隐含一项 API 约定:传递给内核的任何内存都被假定为缓存一致的,因此内核数据结构不得在不缓存的区域中创建。
CPU 掩码
实时应用程序通常希望主动将工作划分到各物理 CPU,而不是完全依赖内核调度器决定执行哪些线程。Zephyr 提供一组由 Kconfig 变量 CONFIG_SCHED_CPU_MASK 控制的 API,可为每个线程关联一组特定 CPU,指明它可以在哪些 CPU 上运行。
默认情况下,新线程可以在任意 CPU 上运行。使用指定 CPU ID 调用 k_thread_cpu_mask_disable(),会禁止该线程今后在此 CPU 上运行。相应地,k_thread_cpu_mask_enable() 会重新允许执行。还提供 k_thread_cpu_mask_clear() 和 k_thread_cpu_mask_enable_all() 作为便捷 API。显然,不能对可运行的线程调用这些 API。线程必须处于阻塞或挂起状态,否则返回 -EINVAL。
三种调度器后端均支持 CPU 掩码过滤,但性能影响不同:
CONFIG_SCHED_SIMPLE:以 O(N) 复杂度线性扫描运行队列;每次上下文切换都会遍历整个列表,寻找第一个符合条件的线程。CONFIG_SCHED_SCALABLE:以 O(N) 复杂度中序遍历红黑树;保持优先级顺序,但如果大量线程被掩码排除,可能需要遍历整棵树。CONFIG_SCHED_MULTIQ:从最高到最低扫描优先级桶,并遍历各桶中的链表;最坏情况为 O(P·N),其中 P 为非空优先级的数量。
对于使用 CONFIG_SCHED_CPU_MASK_PIN_ONLY 的工作负载,每个 CPU 都维护独立的运行队列,因此调度器只需检查该队列,没有掩码过滤开销。
请注意,在 CONFIG_SCHED_CPU_MASK_PIN_ONLY 模式下,不允许使用 k_thread_cpu_mask_clear()、k_thread_cpu_mask_enable_all() 和 k_thread_cpu_mask_disable(),因为这些操作可能产生并非恰好只有一位被置位的掩码,从而违反每个线程必须恰好绑定到一个 CPU 的不变量。
SMP 启动过程
Zephyr SMP 内核的启动与单处理器内核相同。辅助 CPU 在架构层中最初处于禁用状态。包括设备初始化在内的所有标准内核初始化,都会在其他 CPU 上线之前,由单个 CPU 完成。
在进入应用程序 main() 函数之前,内核调用 z_smp_init(),开始 SMP 初始化过程。此过程遍历配置的 CPU,并针对每个 CPU 通过 arch_cpu_start() 调用架构层。传给该函数的参数包括:供目标 CPU 用作栈的内存区域(实际上使用的是稍后成为该 CPU 中断栈的区域)、在该 CPU 上运行的本地 smp_init_top() 回调函数地址,以及指向“启动标志”地址的指针,该标志用作原子信号。
随后,架构层调用各 CPU 上的本地 SMP 初始化例程(smp_init_top())。请注意,此时中断仍被屏蔽。此例程负责调用 smp_timer_init(),设置定时器驱动程序所需的状态。在许多架构上,定时器是每个 CPU 独有的设备,因此需要在辅助 CPU 上单独配置。随后,例程通过自旋等待主线程释放原子“启动标志”,确保在任何 Zephyr 应用程序代码运行前完成所有 SMP 初始化;最后调用 z_swap(),通过标准调度器 API 将控制权转交给合适的可运行线程。
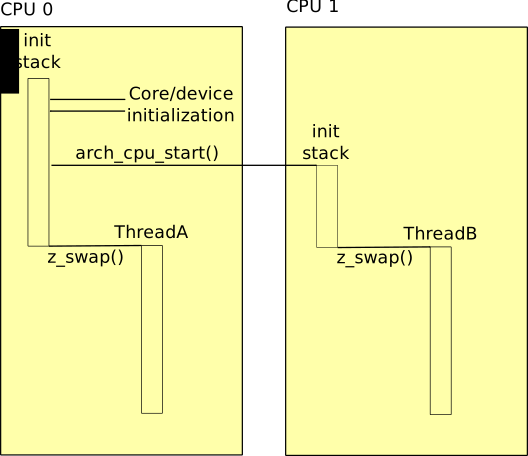
默认情况下,内核会在此启动过程中启用所有可用 CPU。如果某个 CPU 的设备树节点带有 zephyr,deferred-start 标志,则跳过该 CPU,使其保持禁用,以便架构、SoC、开发板或应用程序代码稍后在运行时启动它。延迟启动以 CPU 为单位配置,因此系统可在启动时启用部分辅助 CPU,将其他 CPU 留待按需启动。延迟启动的 CPU 通过 k_smp_cpu_start() 启动,该函数会执行完整的每 CPU 初始化;对应的 k_smp_cpu_resume() 用于让之前停止的 CPU 重新上线,不重复执行一次性初始化。
处理器间中断
在多处理器环境中,有时本地 CPU 修改的状态需要由另一个处理器同步处理。
一个例子是 Zephyr 的 k_thread_abort() API:只有当被中止的线程不再可运行时,它才能返回。如果该线程当前正在另一个 CPU 上运行,实现这一点就变得困难。
另一个例子是低功耗空闲。许多设备明确要求,系统空闲必须采用低功耗模式,并尽可能禁用或推迟中断(包括周期性定时器中断)。如果某个 CPU 处于这种状态,而另一个 CPU 上有线程变为可运行,空闲 CPU 就无法“醒来”处理新出现的可运行负载。
因此,在可能的情况下,Zephyr 的 SMP 架构应实现处理器间中断。当前框架非常简单:架构至少提供 arch_sched_broadcast_ipi() 调用,调用后会向所有 CPU 请求中断(当前 CPU 除外,不过也允许向当前 CPU 发出中断)。如果架构支持定向 IPI(参见 CONFIG_ARCH_HAS_DIRECTED_IPIS),还会提供 arch_sched_directed_ipi() 调用,调用后向指定的 CPU 请求中断。收到中断请求的 CPU 会执行调度器实现的 z_sched_ipi() 函数。预计这些 API 将逐步扩展更多功能(例如跨 CPU 调用),而这里与调度器相关的调用将基于更通用的框架实现。
支持定向 IPI 时,线程变为就绪后,调度器只通知确实需要重新调度的 CPU,而不是向所有其他 CPU 广播。这避免了打扰当前线程无需被抢占的 CPU,从而减少总体中断负载。
请注意,并非所有 SMP 架构都有可用的 IPI 机制(可能缺失,或只是未公开文档、尚未实现)。在这种情况下,Zephyr 提供行为正确但可能不够理想的回退方案。
借助此机制,k_thread_abort() 在 SMP 中的实现只略微复杂一些:如果线程确实在另一个 CPU 上运行(调度器内部可以原子地检测),就广播 IPI 并自旋,等待线程变为“DEAD”或重新进入队列(后一种情况下,按单处理器模式相同的方式终止它)。请注意,任何中断退出时都会检查“已中止”状态,因此 IPI 本身不需要特殊处理。这也使得 IPI 不可用时可以采用合理的回退方案:直接自旋,等待目标 CPU 收到任意中断,但等待时间可能长得多!
同样,只需一个空的 IPI 处理函数就能实现空闲唤醒。如果向空的运行队列中添加线程(即可能存在空闲 CPU),就广播 IPI。其他 CPU 在中断退出时便能看到新线程,并在可用时切换到它。
但如果没有 IPI,需要中断来唤醒的低功耗空闲就无法同步启动新线程。此时的变通方案影响更大:Zephyr 不会 进入系统空闲处理函数,而是在空闲循环中自旋,高频检查调度器状态以寻找新线程(但不会一直针对该状态自旋,否则会造成严重的锁竞争)。预期有功耗限制的 SMP 应用程序始终会提供 IPI,因此这段代码只会用于测试,或用于没有功耗要求的系统。
IPI 级联
内核无法控制系统中各 CPU 处理 IPI 的顺序。通常这不是问题,一组 IPI 就足以触发 N 个 CPU 重新调度,使它们执行优先级最高的 N 个就绪线程。使用 CPU 掩码时,可能存在不止一个可以在 N 个 CPU 上调度的有效线程集合(不要与最优线程集合混淆),而单组 IPI 可能不足以形成其中任何一个有效集合。
备注
不使用 CPU 掩码时,最优线程集合与有效线程集合相同。但使用 CPU 掩码时,可能存在多个有效集合,其中一个可能是最优集合。
为更清楚地说明区别,考虑一个双 CPU 系统,就绪线程 T1 和 T2 的优先级分别为 1 和 2。假设 T2 绑定到 CPU0,而 T1 未绑定。如果 CPU0 执行 T2,CPU1 执行 T1,则此集合既有效又最优。但如果 CPU0 执行 T1,而 CPU1 空闲,这也属于有效集合,只是不是最优集合。
当单组 IPI 不足以产生有效集合时,最终执行的线程集合预计接近有效集合,后续 IPI 通常会很快纠正这一情况。但如果这种近似结果或延迟都不可接受,可以启用 CONFIG_SCHED_IPI_CASCADE,让内核生成级联 IPI,直到为各 CPU 选出有效的就绪线程集合。
IPI 级联会带来三类开销或代价,因此默认禁用。首先,新线程抢占旧线程时,发出 IPI 的 CPU 必须将旧线程与其他 CPU 上执行的线程进行比较,从而产生开销。其次,收到 IPI 的 CPU 必须处理中断,也会产生开销。第三,前述第一种情况引起的级联,会使线程短暂切入后又被切出,表现为断断续续的执行。
IPI 工作项
内核允许开发者使用一个或多个 IPI 工作项,在其他 CPU 上以 ISR 级别执行函数。使用 k_ipi_work_add() 将 IPI 工作项加入指定 CPU 的工作队列后,目标 CPU 会在收到 IPI 后处理这些工作项。调用 k_ipi_work_signal() 发出 IPI,调用 k_ipi_work_wait() 等待目标 CPU 完成 IPI 工作项。任意时刻只允许一个等待者。
备注
IPI 工作项只会被添加到其他 CPU 的 IPI 工作队列中。如果在线程级别添加 IPI 工作项,开发者必须确保当前线程在发出 IPI 之前不会迁移到其他 CPU。
使用示例
以下代码展示了某个 CPU 处理 ISR 后,如何使用 IPI 工作项更新一组 CPU 上的状态信息。
struct k_ipi_work my_work;

void remote_cpu_action(struct k_ipi_work *arg)
{
    ...
}

void my_isr(void)
{
    /*
     * Wait for previous use of <my_work> to complete.
     * It assumes that <my_work> was initialized elsewhere.
     */

    uint32_t cpu_mask = <bitmask identifying CPUs to update>;

    while (k_ipi_work_wait(&my_work, K_NO_WAIT) == -EAGAIN) {
    }

    /* Add and signal the new work */

    k_ipi_work_add(&my_work, cpu_mask, remote_cpu_action);

    k_ipi_work_signal();
}
SMP 内核内部机制
通常,Zephyr 内核代码不依赖于是否启用 SMP,与应用程序代码一样,无论可用 CPU 数量多少都能正确工作。不过,少数部分在结构或行为上存在明显变化。
每 CPU 数据
在 SMP 模式下,许多核心内核数据都需要为每个 CPU 分别实现。例如,由于多个线程并发运行,_current 线程指针显然需要反映本地正在运行的线程。同样,每个物理 CPU 都需要创建并分配内核提供的中断栈,以及用于检测 ISR 状态的中断嵌套计数。
这些字段现已移至 _kernel 结构体内独立的 _cpu 实例中。后者包含一个按 ID 索引的 cpus[] 数组。对于使用旧语法和汇编偏移访问 cpus[0] 字段的传统单处理器代码,系统提供了兼容字段。
请注意,对架构层的一项重要要求是,在内核上下文中必须能够快速获取指向当前 CPU 结构体的指针。预期 arch_curr_cpu() 使用 CPU 提供的寄存器或寻址模式实现,以便在任意上下文切换或中断期间保留此值,并使所有内核模式代码均可访问它。
类似地,在单处理器系统上,Zephyr 只需创建一个优先级最低的全局“空闲线程”,而在 SMP 中,可能每个 CPU 都需要一个。调度器中的“_is_idle()”内部判断处于性能关键路径,此时不能再简单地将线程指针与已知静态变量比较,因而更加复杂。在 SMP 模式下,空闲线程通过线程结构体中的独立字段区分。
基于 switch 的上下文切换
Zephyr 传统的上下文切换原语是 z_swap()。遗憾的是,此函数没有用于指定目标线程的参数。它一直假定,调度器在上次修改状态时已经作出抢占决策,并将得到的“下一个线程”指针缓存到某处,架构上下文切换原语可以通过简单的结构体偏移找到它。这种方法在 SMP 中行不通,因为自当前 CPU 上次退出调度器后,另一个 CPU 可能已经修改了调度器状态(例如,它可能已经在运行那个缓存的线程!)。
因此,SMP 中“切换到哪个线程”的决策必须与 swap 调用同步进行。又由于我们不希望各架构的汇编代码处理调度器内部状态,Zephyr 为 SMP 系统要求了更底层的上下文切换原语:arch_switch() 总是在屏蔽中断的情况下调用,并且恰好接受两个参数。第一个是指向目标上下文的不透明句柄(由架构定义);第二个是指向此类句柄的指针,用于保存被切出线程生成的句柄。内核随后在此原语之上实现可移植的 z_swap(),将相关调度逻辑放在无需架构理解的位置。
同样,中断退出时,基于 switch 的架构应调用 z_get_next_switch_handle(),从调度器获取下一个要运行的线程。z_get_next_switch_handle() 的参数可以是被中断线程的“句柄”,其类型与 arch_switch() 使用的不透明类型相同;如果暂时还不能将该线程交还给调度器,则为 NULL。选择句柄值还是 NULL,取决于 CPU 中断模式的实现方式。
拥有较大 CPU 寄存器组的架构,在发生中断时通常只将调用者保存寄存器保存在当前线程栈上,以尽量降低中断延迟;而仅在调用 arch_switch() 时保存被调用者保存寄存器,以尽量降低上下文切换延迟。这类架构必须向 z_get_next_switch_handle() 传入 NULL,判断是否有新线程需要调度。如果有,则继续执行自身的 arch_switch() 或派生实现;否则直接退出中断模式。在前一种情况下,切换代码负责在线程上下文完全保存后,将被切出线程生成的句柄存入该线程的“switch_handle”字段。
如果某个架构在进入中断模式时已经保存了完整线程状态,就可以直接将该线程句柄传递给 z_get_next_switch_handle(),一步完成操作。
请注意,SMP 要求启用 CONFIG_USE_SWITCH,但反之不成立。即使单处理器架构构建时将 CONFIG_SMP 设置为 No,也仍然可以选择使用 arch_switch() 实现上下文切换。
线程队列顺序
在 SMP 系统中,线程被更高优先级线程抢占后,会被移到其优先级队列的末尾。相比之下,在单处理器系统中,被抢占的线程不会移到优先级队列末尾,而是等待重新获得 CPU,保持相对于其他同优先级线程的原有顺序。