日志记录
日志记录 API 提供了通用接口,用于处理开发者发出的消息。消息经由前端传递,随后由活动的后端进行处理。如有需要,可以使用自定义前端和后端。
日志记录功能摘要:
延迟日志记录将耗时操作转移到已知上下文中执行,而不是在调用时处理和发送日志消息,从而缩短记录一条消息所需的时间。
支持多个后端(最多 9 个后端)。
支持自定义前端。它可以与后端协同工作。
在模块级别进行编译时过滤。
每个后端的运行时过滤相互独立。
在模块实例级别进行额外的运行时过滤。
通过用户提供的函数添加时间戳。时间戳可以是 32 位或 64 位。
用于转储数据的专用 API。
用于处理瞬态字符串的专用 API。
支持 panic 模式 —— 在 panic 模式下,日志记录切换为阻塞、同步处理。
支持 printk —— printk 消息可以重定向到日志记录。
面向多域/多处理器系统的设计。
支持记录浮点变量和 long long 参数。
内置对用作参数的瞬态字符串的复制。
支持多域日志记录。
速率限制日志记录宏,可在频繁生成消息时防止日志泛滥。
日志记录 API 在编译时和运行时都具有高度可配置性。使用 Kconfig 选项(参见 日志 Kconfig 选项 一节)可以逐步将日志从编译中移除,从而在不需要日志时减小镜像大小并缩短执行时间。在编译期间,可以按模块和严重性级别过滤日志。
日志也可以在编译时包含进来,但在运行时使用专用 API 进行过滤。运行时过滤对每个后端和每个日志消息源都是独立的。日志消息源可以是模块,也可以是模块的特定实例。
系统中有四个严重性级别:error、warning、info 和 debug。对于每个严重性级别,日志记录 API include/zephyr/logging/log.h 都提供了一组专用宏。日志记录器 API 还提供用于记录数据的宏。
对于每个级别,可使用以下一组宏:
LOG_X用于标准 printf 风格的消息,例如LOG_ERR。LOG_HEXDUMP_X用于转储数据,例如LOG_HEXDUMP_WRN。LOG_INST_X用于与特定实例关联的标准 printf 风格消息,例如LOG_INST_INF。LOG_INST_HEXDUMP_X用于转储与特定实例关联的数据,例如LOG_INST_HEXDUMP_DBG
warning 级别还提供以下附加宏:
LOG_WRN_ONCE用于只关注首次出现的警告。
所有严重性级别都提供速率限制日志记录宏,以防止日志泛滥:
LOG_X_RATELIMIT用于使用默认速率的速率限制标准 printf 风格消息,例如LOG_ERR_RATELIMIT。LOG_X_RATELIMIT_RATE用于使用自定义速率的速率限制标准 printf 风格消息,例如LOG_ERR_RATELIMIT_RATE。LOG_HEXDUMP_X_RATELIMIT用于使用默认速率的速率限制数据转储,例如LOG_HEXDUMP_WRN_RATELIMIT。LOG_HEXDUMP_X_RATELIMIT_RATE用于使用自定义速率的速率限制数据转储,例如LOG_HEXDUMP_WRN_RATELIMIT_RATE。
便捷宏使用 CONFIG_LOG_RATELIMIT_INTERVAL_MS 指定的默认速率,而显式速率宏接受一个速率参数(以毫秒为单位),用于指定日志消息之间的最小间隔。
配置分为两类:每个模块的配置和全局配置。全局启用日志记录后,它将对各个模块生效。但是,模块可以在本地禁用日志记录。每个模块都可以指定自己的日志级别。模块在使用 API 之前必须定义 LOG_LEVEL 宏。除非设置了全局覆盖,否则将采用模块的日志级别。全局覆盖只能提高日志级别,不能用于降低已设置为更高值的模块日志级别。还可以通过提供系统中存在的最大严重性级别来全局限制日志,这里的最大是指最低严重性(例如,如果系统中的最大级别设置为 info,则表示存在 error、warning 和 info 级别,但排除 debug 消息)。
每个使用日志记录的模块都必须指定其唯一名称,并向日志记录系统注册自身。如果模块由多个文件组成,注册操作在其中一个文件中执行,但每个文件都必须定义模块名称。
日志记录器的默认前端设计为线程安全,并尽可能缩短记录消息所需的时间。默认情况下,调用日志记录 API 时不会执行字符串格式化或访问传输层等耗时操作。调用日志记录 API 时会创建一条消息并将其添加到列表中。系统使用专用的、可配置的缓冲区作为日志消息池。消息有两种类型:标准消息和十六进制转储消息。每条消息都包含源 ID(模块或实例 ID 以及可能用于多处理器系统的域 ID)、时间戳和严重性级别。标准消息包含指向字符串和参数的指针。十六进制转储消息包含已复制的数据和字符串。
全局 Kconfig 选项
这些选项位于以下路径 subsys/logging/Kconfig。
CONFIG_LOG:全局开关,用于打开/关闭日志记录。
操作模式:
CONFIG_LOG_MODE_DEFERRED:延迟模式。
CONFIG_LOG_MODE_IMMEDIATE:立即(同步)模式。
CONFIG_LOG_MODE_MINIMAL:最小占用模式。
过滤选项:
CONFIG_LOG_RUNTIME_FILTERING:支持在运行时重新配置过滤。
CONFIG_LOG_DEFAULT_LEVEL:默认级别,设置未自行设置日志级别的模块所使用的日志级别。
CONFIG_LOG_OVERRIDE_LEVEL:当模块日志级别未设置或低于覆盖值时,覆盖模块的日志级别。
CONFIG_LOG_MAX_LEVEL:编译进系统的最大(最低严重性)级别。
处理选项:
CONFIG_LOG_MODE_OVERFLOW:当无法分配新消息时,丢弃最旧的消息。
CONFIG_LOG_BLOCK_IN_THREAD:如果启用,并且无法分配新的日志消息,线程上下文将阻塞,最长阻塞时间为 CONFIG_LOG_BLOCK_IN_THREAD_TIMEOUT_MS,或者直到日志消息被分配为止。
CONFIG_LOG_PRINTK:将 printk 调用重定向到日志记录。
CONFIG_LOG_PROCESS_TRIGGER_THRESHOLD:当缓冲的日志消息数量达到该阈值时,唤醒专用线程(参见 log_thread_set() 函数)。如果启用了 CONFIG_LOG_PROCESS_THREAD,则内部线程会使用该阈值。
CONFIG_LOG_PROCESS_THREAD:启用后,将创建负责处理日志的日志线程。
CONFIG_LOG_PROCESS_THREAD_STARTUP_DELAY_MS:日志线程启动前的延迟毫秒数。
CONFIG_LOG_BUFFER_SIZE:专用于循环数据包缓冲区的字节数。
CONFIG_LOG_FRONTEND:将日志定向到自定义前端。
CONFIG_LOG_FRONTEND_ONLY:消息发送到前端时不使用任何后端。
CONFIG_LOG_FRONTEND_OPT_API:针对最常见简单消息优化的可选 API。
CONFIG_LOG_CUSTOM_HEADER:将应用提供的头文件注入 log.h
CONFIG_LOG_TIMESTAMP_64BIT:64 位时间戳。
CONFIG_LOG_SIMPLE_MSG_OPTIMIZE:针对大小和性能优化简单日志消息。该选项仅适用于 32 位架构。
格式化选项:
CONFIG_LOG_FUNC_NAME_PREFIX_ERR:在标准 ERROR 日志消息前添加函数名。十六进制转储消息不添加前缀。
CONFIG_LOG_FUNC_NAME_PREFIX_WRN:在标准 WARNING 日志消息前添加函数名。十六进制转储消息不添加前缀。
CONFIG_LOG_FUNC_NAME_PREFIX_INF:在标准 INFO 日志消息前添加函数名。十六进制转储消息不添加前缀。
CONFIG_LOG_FUNC_NAME_PREFIX_DBG:在标准 DEBUG 日志消息前添加函数名。十六进制转储消息不添加前缀。
CONFIG_LOG_BACKEND_SHOW_TIMESTAMP:允许后端在打印日志时输出时间戳。
CONFIG_LOG_BACKEND_SHOW_LEVEL:允许后端在打印日志时输出级别。
CONFIG_LOG_BACKEND_SHOW_COLOR:启用错误(红色)和警告(黄色)的着色。
CONFIG_LOG_BACKEND_FORMAT_TIMESTAMP:启用后,时间戳会格式化为 hh:mm:ss:mmm,uuu 格式;否则按原始格式打印。
后端选项:
CONFIG_LOG_BACKEND_UART:启用内置 UART 后端。
CONFIG_LOG_BACKEND_NET:启用内置网络后端,用于将 syslog 消息发送到网络服务器。
用法
在模块中使用日志记录
为了在模块中使用日志记录,必须指定模块的唯一名称,并使用 LOG_MODULE_REGISTER 注册模块。可选地,可以在第二个参数中指定模块的编译时日志级别。如果未提供自定义日志级别,则使用默认日志级别(CONFIG_LOG_DEFAULT_LEVEL)。
#include <zephyr/logging/log.h>
LOG_MODULE_REGISTER(foo, CONFIG_FOO_LOG_LEVEL);
如果模块由多个文件组成,则 LOG_MODULE_REGISTER() 应当只出现在其中一个文件中。其他每个文件都应使用 LOG_MODULE_DECLARE 声明其在该模块中的成员身份。可选地,可以在第二个参数中指定模块的编译时日志级别。如果未提供自定义日志级别,则使用默认日志级别(CONFIG_LOG_DEFAULT_LEVEL)。
#include <zephyr/logging/log.h>
/* In all files comprising the module but one */
LOG_MODULE_DECLARE(foo, CONFIG_FOO_LOG_LEVEL);
为了在头文件中实现的函数里使用日志 API,必须在调用日志 API 之前于函数体中使用 LOG_MODULE_DECLARE 宏。可选地,可以在第二个参数中指定模块的编译时日志级别。如果未提供自定义日志级别,则使用默认日志级别(CONFIG_LOG_DEFAULT_LEVEL)。
#include <zephyr/logging/log.h>

static inline void foo(void)
{
     LOG_MODULE_DECLARE(foo, CONFIG_FOO_LOG_LEVEL);

     LOG_INF("foo");
}
可以使用专用的 Kconfig 模板(subsys/logging/Kconfig.template.log_config)创建本地日志级别配置。
下面的示例展示了该模板的用法。结果将生成 CONFIG_FOO_LOG_LEVEL:
module = FOO
module-str = foo
source "subsys/logging/Kconfig.template.log_config"
在模块实例中使用日志记录
对于多实例模块,如果其实例在整个系统中被广泛使用,启用日志会导致日志泛滥。日志记录器提供了一些工具,可以在实例级别而不是模块级别进行过滤。在这种情况下,可以为特定实例启用日志记录。
为了使用实例级过滤,必须执行以下步骤:
在实例结构体中声明指向特定日志结构的指针。为此需要使用
LOG_INSTANCE_PTR_DECLARE。
#include <zephyr/logging/log_instance.h>

struct foo_object {
     LOG_INSTANCE_PTR_DECLARE(log);
     uint32_t id;
}
模块必须提供用于实例化的宏。在该宏中会注册日志实例,并在对象结构体中初始化日志实例指针。
#define FOO_OBJECT_DEFINE(_name)                             \
     LOG_INSTANCE_REGISTER(foo, _name, CONFIG_FOO_LOG_LEVEL) \
     struct foo_object _name = {                             \
             LOG_INSTANCE_PTR_INIT(log, foo, _name)          \
     }
注意,如果禁用日志记录,则不会创建日志实例和指向该实例的指针。
为了在源文件中使用实例日志 API,必须使用 LOG_LEVEL_SET 设置编译时日志级别。
LOG_LEVEL_SET(CONFIG_FOO_LOG_LEVEL);

void foo_init(foo_object *f)
{
     LOG_INST_INF(f->log, "Initialized.");
}
为了在头文件中使用实例日志 API,必须使用 LOG_LEVEL_SET 设置编译时日志级别。
static inline void foo_init(foo_object *f)
{
     LOG_LEVEL_SET(CONFIG_FOO_LOG_LEVEL);

     LOG_INST_INF(f->log, "Initialized.");
}
控制日志记录
默认情况下,延迟模式下的日志处理由自动启动的专用任务在内部完成。不过,如果禁用了多线程,该任务可能不可用。也可以通过取消设置 CONFIG_LOG_PROCESS_TRIGGER_THRESHOLD 来禁用它。在这种情况下,可以使用 include/zephyr/logging/log_ctrl.h 中定义的 API 控制日志记录。日志记录必须先初始化才能使用。可选地,用户可以提供一个返回时间戳值的函数。如果未提供,则使用 k_cycle_get 或 k_cycle_get_32 来生成时间戳。log_process() 函数用于触发处理一条日志消息(如果有待处理的消息),如果还有更多待处理的消息,则返回 true。不过,建议使用宏包装器(LOG_INIT 和 LOG_PROCESS),它们会处理日志记录被禁用的情况。
下面的代码片段展示了如何在简单的永久循环中处理日志记录。
#include <zephyr/logging/log_ctrl.h>

int main(void)
{
     LOG_INIT();
     /* If multithreading is enabled provide thread id to the logging. */
     log_thread_set(k_current_get());

     while (1) {
             if (LOG_PROCESS() == false) {
                     /* sleep */
             }
     }
}
如果日志由线程(用户线程或内部线程)处理,则可以启用一个特性:当缓冲的日志消息达到一定数量时唤醒处理线程(参见 CONFIG_LOG_PROCESS_TRIGGER_THRESHOLD)。
速率限制日志记录
速率限制日志宏提供了一种在消息频繁生成时防止日志泛滥的方法。这些宏确保日志消息的输出频率不高于指定的间隔,类似于 Linux 的 printk_ratelimited 功能。
速率限制日志系统提供两类宏:
便捷宏(使用默认速率): - LOG_ERR_RATELIMIT - 速率限制的错误消息 - LOG_WRN_RATELIMIT - 速率限制的警告消息 - LOG_INF_RATELIMIT - 速率限制的信息消息 - LOG_DBG_RATELIMIT - 速率限制的调试消息 - LOG_HEXDUMP_ERR_RATELIMIT - 速率限制的错误十六进制转储 - LOG_HEXDUMP_WRN_RATELIMIT - 速率限制的警告十六进制转储 - LOG_HEXDUMP_INF_RATELIMIT - 速率限制的信息十六进制转储 - LOG_HEXDUMP_DBG_RATELIMIT - 速率限制的调试十六进制转储
显式速率宏(使用自定义速率): - LOG_ERR_RATELIMIT_RATE - 速率限制的错误消息,可自定义速率 - LOG_WRN_RATELIMIT_RATE - 速率限制的警告消息,可自定义速率 - LOG_INF_RATELIMIT_RATE - 速率限制的信息消息,可自定义速率 - LOG_DBG_RATELIMIT_RATE - 速率限制的调试消息,可自定义速率 - LOG_HEXDUMP_ERR_RATELIMIT_RATE - 速率限制的错误十六进制转储,可自定义速率 - LOG_HEXDUMP_WRN_RATELIMIT_RATE - 速率限制的警告十六进制转储,可自定义速率 - LOG_HEXDUMP_INF_RATELIMIT_RATE - 速率限制的信息十六进制转储,可自定义速率 - LOG_HEXDUMP_DBG_RATELIMIT_RATE - 速率限制的调试十六进制转储,可自定义速率
便捷宏使用 CONFIG_LOG_RATELIMIT_INTERVAL_MS 指定的默认速率(默认为 5000ms)。显式速率宏接受一个速率参数(单位为毫秒),用于指定日志消息之间的最小间隔。速率限制是按宏调用点进行的,这意味着对速率限制宏的每次不同调用都有各自独立的速率限制。
用法示例:
#include <zephyr/logging/log.h>
#include <zephyr/kernel.h>

LOG_MODULE_REGISTER(my_module, CONFIG_LOG_DEFAULT_LEVEL);

void process_data(void)
{
    /* Convenience macros using default rate (CONFIG_LOG_RATELIMIT_INTERVAL_MS) */
    LOG_WRN_RATELIMIT("Data processing warning: %d", error_code);
    LOG_ERR_RATELIMIT("Critical error occurred: %s", error_msg);
    LOG_INF_RATELIMIT("Processing status: %d items", item_count);
    LOG_HEXDUMP_WRN_RATELIMIT(data_buffer, data_len, "Data buffer:");

    /* Explicit rate macros with custom intervals */
    LOG_WRN_RATELIMIT_RATE(1000, "Fast rate warning: %d", error_code);
    LOG_ERR_RATELIMIT_RATE(30000, "Slow rate error: %s", error_msg);
    LOG_INF_RATELIMIT_RATE(2000, "Custom rate status: %d items", item_count);
    LOG_HEXDUMP_ERR_RATELIMIT_RATE(5000, data_buffer, data_len, "Error data:");
}
速率限制日志记录特别适用于以下情况:
可能频繁发生、但不需要使日志泛滥的错误状况
紧凑循环或高频回调中的状态更新
可能使日志记录系统不堪重负的调试信息
可能反复失败的网络或 I/O 操作
配置
可以使用以下 Kconfig 选项配置速率限制日志记录:
CONFIG_LOG_RATELIMIT- 用于启用/禁用速率限制日志记录的总开关CONFIG_LOG_RATELIMIT_INTERVAL_MS- 便捷宏的默认间隔(5000ms)
禁用 CONFIG_LOG_RATELIMIT 时,速率限制宏的行为由 CONFIG_LOG_RATELIMIT_FALLBACK 选择项控制:
CONFIG_LOG_RATELIMIT_FALLBACK_LOG- 所有速率限制宏都像常规日志宏一样工作CONFIG_LOG_RATELIMIT_FALLBACK_DROP- 所有速率限制宏都展开为空操作(默认)
这样,当速率限制不可用时,用户可以控制速率限制日志宏是始终打印还是被完全抑制。
速率限制使用静态变量和 k_uptime_get_32() 实现,用于跟踪每个调用点上次记录日志的时间。
日志 panic
发生错误状况时,系统通常无法再依赖调度器或中断。在这种情况下,延迟日志消息处理不是可行的选择。日志记录器控制 API 提供了用于进入 panic 模式的函数(log_panic()),在此类情况下应调用该函数。
调用 log_panic() 时,会向所有活动后端发送 _panic_ 通知。所有后端都收到通知后,所有已缓冲的消息都会被刷新。从那一刻起,所有日志都以阻塞方式处理。
Printk
通常,日志记录和 printk() 使用相同的输出,两者会相互争用。如果输出不支持抢占,这可能会导致问题;但也可能造成输出损坏,因为日志数据会与 printk 数据交错。不过,可以通过启用 CONFIG_LOG_PRINTK 将 printk 消息重定向到日志子系统。在这种情况下,printk 条目会被视为级别为 0 的日志消息(无法禁用它们)。启用后,日志记录会管理输出,因此不会发生交错。但在延迟模式下,printk 的行为会发生变化,因为输出会延迟到日志线程处理数据时才进行。默认情况下会启用 CONFIG_LOG_PRINTK。
架构
日志记录由 3 个主要部分组成:
前端
核心
后端
日志消息由日志来源生成,日志来源可以是模块或模块的实例。
默认前端
当在日志来源中调用日志 API(例如 LOG_INF)时,会启用默认前端;它负责过滤消息(编译时和运行时)、为消息分配缓冲区、创建消息并提交消息。由于日志 API 可以在中断中调用,前端经过优化,可以尽可能快地记录消息。
日志消息
日志消息包含消息描述符(来源、域和级别)、时间戳、格式化字符串的详细信息(参见 Cbprintf 打包)以及可选数据。日志消息存储在连续的内存块中。内存从环形数据包缓冲区(多生产者单消费者包缓冲区)分配,这会带来一些影响:
每条消息都是一个自包含的连续内存块,因此适合复制消息(例如用于离线处理)。
消息必须按顺序释放。后端处理是同步的。后端可以复制消息以进行延迟处理。
日志消息具有以下格式:
消息头部 |
2 位:MPSC 数据包缓冲区头部 |
1 位:跟踪/日志消息标志 |
|
3 位:域 ID |
|
3 位:级别 |
|
10 位:Cbprintf 包长度 |
|
12 位:数据长度 |
|
1 位:保留 |
|
指针:指向源描述符的指针 [1] |
|
32 位或 64 位:时间戳 [1] |
|
可选填充 [2] |
|
Cbprintf 包
(可选)
|
Header |
参数 |
|
追加的字符串 |
|
十六进制转储数据(可选) |
|
对齐填充(可选) |
|
脚注
日志消息分配
前端可能无法分配消息。如果系统在特定时间范围内生成的日志消息超过了它能处理的数量,就会发生这种情况。处理这种情况有两种策略:
无溢出:如果无法为消息分配空间,则丢弃新日志。
溢出:释放最旧的待处理消息,直到能够分配新消息为止。通过
CONFIG_LOG_MODE_OVERFLOW启用。请注意,这会降低性能,因此建议调整缓冲区大小和启用的日志数量,以减少丢弃。
运行时过滤
如果启用了运行时过滤,则会为每个日志来源在 RAM 中声明一个过滤器结构体。该过滤器使用 32 位,划分为十个 3 位槽位。除 槽位 0 外,每个槽位存储系统中某个后端的当前过滤器。槽位 0 (第 0-2 位)用于聚合给定日志来源的最大过滤器设置。聚合槽位决定是否为给定条目创建日志消息,因为它表明是否至少有一个后端需要该日志条目。当消息由核心处理时,会检查各后端槽位,以确定消息是否被给定后端接受。与编译时过滤相反,由于日志会被编译进来,二进制占用空间会增大。
在下面的示例中,后端 1 设置为接收错误(槽位 1),后端 2 设置为最高到 info 级别(槽位 2)。槽位 3-9 未使用。聚合过滤器(槽位 0)设置为 info 级别,来自该特定来源的消息最高到该级别都会被缓冲。
slot 0 |
slot 1 |
slot 2 |
slot 3 |
... |
slot 9 |
INF |
ERR |
INF |
OFF |
... |
OFF |
自定义前端
自定义前端通过 CONFIG_LOG_FRONTEND 启用。日志会被定向到 include/zephyr/logging/log_frontend.h 中声明的函数。如果启用了 CONFIG_LOG_FRONTEND_ONLY 选项,则不会创建日志消息,也不会处理任何后端。否则,自定义前端可以与后端共存。
在某些情况下,需要在宏级别重定向日志。对于这些情况,可以使用 CONFIG_LOG_CUSTOM_HEADER 在 include/zephyr/logging/log.h 的末尾注入一个由应用提供的名为 zephyr_custom_log.h 的头文件。
使用 ARM Coresight STM(System Trace Macrocell)的前端
有关使用 ARM Coresight STM 进行日志记录的更多详细信息,请参见 ARM Coresight STM 前端。
日志字符串
字符串参数由 Cbprintf 打包 处理。有关限制和建议,请参见 限制与建议。
多域支持
更复杂的系统可以由多个域组成,每个域都是一个独立的二进制文件。域的示例包括多核 SoC 中的一个核心,或 ARM TrustZone 核心上的其中一个二进制文件(Secure 或 Nonsecure)。
在多域系统上进行跟踪和调试更为复杂,并且需要高效的日志记录系统。可以使用两种方法来组织这种日志记录系统:
在每个域内独立记录日志。此选项并非总是可行,因为它要求每个域都有可用的后端(例如 UART)。这种方法使用起来也可能很麻烦,而且不具备可扩展性,因为日志分别呈现在各自独立的输出上。
使用多域日志记录系统,让来自各个域的日志消息最终汇集到一个根域中,并在那里像单域情况一样进行处理。在这种方法中,日志消息通过域之间的连接在域之间传递,这种连接在一侧由后端创建,并链接到另一侧。
日志链路是这种多域方法中引入的一种接口。日志链路负责接收来自其他域的任何日志消息、创建副本,并将该本地日志消息副本(包括远程数据)放入消息队列。这种特定的日志链路实现与配套的后端实现相匹配,以支持日志消息交换和日志记录器控制,例如配置过滤、获取日志来源名称等。
多域系统中有三种类型的域:
末端域 具有日志记录核心实现和跨域后端。它还可以并行地拥有其他后端。
中继域 具有一个或多个指向其他域的链路,但没有向用户输出日志的后端。它有一个跨域后端,既可以指向另一个中继域,也可以指向根域。
根域 具有一个或多个链路,以及一个向用户输出日志的后端。
多域设置的示例如下图所示:
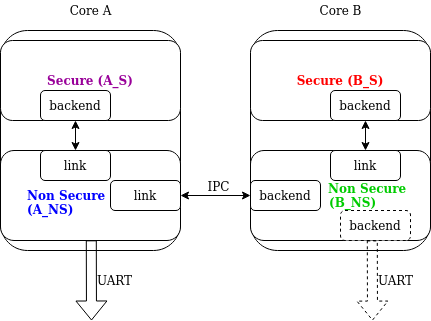
在此架构中,一个链路可以处理多个域。例如,假设有一个包含两个带 TrustZone 的 ARM Cortex-M33 核心的 SoC:核心 A 和核心 B(参见上文的示例)。系统中有四个域,因为每个核心都同时具有一个安全域和一个非安全域。如果 核心 A 非安全域 (A_NS) 是根域,则它有两个链路:一个指向 核心 A 安全域 (A_NS-A_S),另一个指向 核心 B 非安全域 (A_NS-B_NS)。B_NS 域有一个链路,指向 核心 B 安全域 B_NS-B_S,以及一个指向 A_NS 的后端。
由于在所有情况下都存在标准的日志记录子系统,因此始终可以拥有多个后端并同时向它们输出消息。上文插图中 B_NS 域上以虚线表示的 UART 后端就是一个示例。
域 ID
每条日志消息的来源都可以通过头部中的以下字段来标识:source_id 和 domain_id。
分配给 domain_id 的值是相对的。每当某个域创建日志消息时,都会将其 domain_id 设置为 0。当消息跨域时,domain_id 会因为加上链路偏移量而变化。链路偏移量在初始化期间分配,此时日志记录核心会遍历所有已注册的链路并分配偏移量。
第一个链路的偏移量设置为 1。后续的偏移量等于前一个链路的偏移量加上前一个链路中的域数量。
下面的示例展示了为每个域分配的 domain_ids:
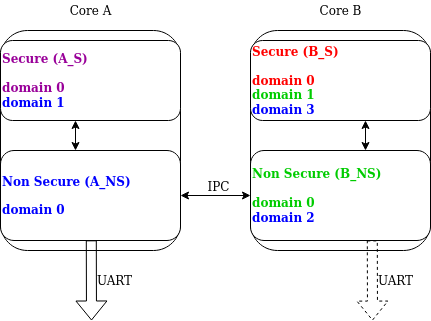
让我们考虑一条在 B_S 域上创建的日志消息:
最初,它的
domain_id设置为0。当 B_NS-B_S 链路收到该消息时,它会加上 B_NS-B_S 偏移量,从而将
domain_id增加到1。该消息被传递给 A_NS。
当 A_NS-B_NS 链路收到该消息时,它会将偏移量(
2)加到domain_id上。最终该消息的domain_id被设置为3,从而唯一标识消息的发起方。
跨域日志消息
在大多数情况下,每个域的地址空间都是独立的,一个域无法直接访问另一个域中的数据。因此,后端可以在消息传递给另一个域之前对其进行部分处理。部分处理可以包括将字符串包转换为 完全自包含 的版本(将只读字符串复制到包主体中)。
在频率和偏移量方面,每个域可以有不同的时间戳来源。日志记录不会进行任何时间戳转换。
运行时过滤
在单域情况下,每个日志来源都有一个专用变量,用于为系统中的每个后端保存运行时过滤设置。在多域情况下,日志消息的发起方并不知道根域中后端的数量。
因此,要在多个域中过滤日志,每个来源在通往根域的路径上都需要在每个域中有一个运行时过滤设置。由于编译期间并不知道其他域中的来源数量,远程来源的运行时过滤必须使用动态分配的内存(每个来源一个字)。当根域中的某个后端更改来自远程域的模块的过滤设置时,本地过滤器会更新。更新之后,会检查聚合过滤器(所有本地后端中的最大值),如果发生变化,则会将该变化通知给远程域。采用这种方法后,运行时过滤在多域和单域场景中的工作方式完全相同。
消息排序
日志记录不提供任何用于跨多个域同步时间戳的机制:
如果各个域具有不同的时间戳来源,消息将按照到达根域缓冲区的先后顺序进行处理。
如果各个域具有相同的时间戳来源,或者存在一种会重新计算时间戳的带外机制,则有 2 种选择:
消息到达根域缓冲区时即被处理。消息是无序的,但由于时间戳指示了消息生成的时间,主机可以对它们进行排序。
链路使用专用缓冲区。处理时会检查每个缓冲区的头部,最先处理最旧的消息。
采用这种方法可以保持消息的顺序,但代价是内存利用率不够理想(因为缓冲区不共享)以及处理延迟增加(参见
CONFIG_LOG_PROCESSING_LATENCY_US)。
日志后端
日志后端使用 LOG_BACKEND_DEFINE 注册。该宏在专用内存段中创建一个实例。后端可以动态启用(log_backend_enable())和禁用。启用 运行时过滤 后,可以使用 log_filter_set() 动态更改给定后端下某个模块日志的过滤设置。模块由源 ID 和域 ID 标识。如果已知源名称,可以通过遍历所有已注册的源来获取源 ID。
日志记录最多支持 9 个并发后端。在处理阶段,日志消息会传递给每个后端。此外,当日志记录进入 panic 模式时,会通过 log_backend_panic() 通知后端。收到该调用后,后端应切换到同步、无中断的操作方式;如果不支持,则应自行关闭。日志记录偶尔会通过 log_backend_dropped() 告知后端被丢弃的消息数量。消息处理 API 因版本而异。
log_backend_msg_process() 用于处理消息。由于日志消息包含带参数的字符串和数据,因此标准消息和十六进制转储消息都使用该函数。它同样适用于延迟日志记录和即时日志记录。
消息格式化
日志记录提供了一组可供后端用来格式化消息的函数。辅助函数位于 include/zephyr/logging/log_output.h 中。
使用 log_output_msg_process() 格式化的示例消息。
[00:00:00.000,274] <info> sample_instance.inst1: logging message
基于字典的日志记录
基于字典的日志记录输出的是二进制格式的日志消息,而不是人类可读的文本。这种二进制格式以格式化字符串各参数的原始存储格式对这些参数进行编码,因此可能比等效的文本更紧凑。对于静态定义的字符串(包括格式字符串和任何字符串参数),编码的是对 ELF 文件的引用,而不是完整字符串。构建时创建的字典包含这些引用与实际字符串之间的映射。这样,离线解析器就能从字典中获取字符串来解析日志消息。在某些场景下,这种二进制格式可以更紧凑地表示日志消息。不过,它需要使用离线解析器,并且用起来不如基于文本的日志消息直观。
请注意,Python 的 struct 模块不支持 long double。因此,包含 long double 的日志消息将无法显示正确的值。
Configuration
以下是与基于字典的日志记录相关的 Kconfig 选项:
CONFIG_LOG_DICTIONARY_SUPPORT启用基于字典的日志记录支持。需要该功能的后端应选中此选项。UART 后端可用于基于字典的日志记录。以下是 UART 后端的附加配置:
CONFIG_LOG_BACKEND_UART_OUTPUT_DICTIONARY_HEX指示 UART 后端为基于字典的日志记录输出十六进制字符。当需要通过终端和控制台手动捕获日志数据时,这很有用。CONFIG_LOG_BACKEND_UART_OUTPUT_DICTIONARY_BIN指示 UART 后端输出二进制数据。
RTT 后端也可用于基于字典的日志记录:
CONFIG_LOG_BACKEND_RTT启用 RTT 后端。CONFIG_LOG_BACKEND_RTT_OUTPUT_DICTIONARY为 RTT 后端启用基于字典的输出。请与CONFIG_USE_SEGGER_RTT一起使用。CONFIG_LOG_BACKEND_RTT_OUTPUT_DICTIONARY_HEX指示 RTT 后端为基于字典的日志记录输出十六进制字符。
Usage
当通过启用相关日志后端来启用基于字典的日志记录时,构建目录中会创建名为 log_dictionary.json 的 JSON 数据库文件。该数据库文件包含供解析器正确解析日志数据的信息。请注意,该数据库文件仅适用于同一次构建,不能用于任何其他构建。
离线解析
要解析先前捕获的日志文件:
./scripts/logging/dictionary/log_parser.py <build dir>/log_dictionary.json <log data file>
该解析器需要两个必需参数,第一个是 JSON 数据库文件的完整路径,第二个是包含日志数据的文件。如果日志数据文件包含十六进制字符(例如当 CONFIG_LOG_BACKEND_UART_OUTPUT_DICTIONARY_HEX=y 时),请在末尾添加可选参数 --hex。这会指示解析器在解析前将十六进制字符转换为二进制。
实时解析
要实时解码基于字典的日志输出,请使用实时日志解析器。它会连接到正在运行的设备,并在二进制日志数据到达时持续进行解码。请注意,实时解析器仅支持二进制字典输出(不支持十六进制编码)。实时解析器支持三种输入模式:
串行(UART):
./scripts/logging/dictionary/live_log_parser.py <build dir>/log_dictionary.json serial <port> <baudrate>
例如,以 115200 波特率从 /dev/ttyACM0 读取:
./scripts/logging/dictionary/live_log_parser.py build/zephyr/log_dictionary.json serial /dev/ttyACM0 115200
JLink RTT:
./scripts/logging/dictionary/live_log_parser.py <build dir>/log_dictionary.json jlink-rtt <device_name>
例如,从 nRF5340 读取 RTT 输出:
./scripts/logging/dictionary/live_log_parser.py build/zephyr/log_dictionary.json jlink-rtt nrf5340_xxaa_app
JLink RTT 模式需要 pylink-square Python 包(pip install pylink-square)。可选参数包括 --channel (用于选择 RTT 通道,默认值为 0)、--speed (用于设置连接速度)以及 --block-address (用于以十六进制指定 RTT 控制块地址)。
文件 / stdin:
./scripts/logging/dictionary/live_log_parser.py <build dir>/log_dictionary.json file <filepath>
省略 <filepath> 时,解析器从 stdin 读取,这样可以将二进制数据直接通过管道输入其中。
有关使用日志解析器的更多示例,请参阅 Dictionary-based logging 示例。
建议与限制
建议如下:
启用
CONFIG_LOG_SPEED可以略微加快延迟日志记录,代价是内存占用略微增加。当指针与
%s格式说明符一起使用并且指向常量字符串时,建议将该指针强制转换为const char *。当指针与
%s格式说明符一起使用并且指向瞬态字符串时,建议将该指针强制转换为char *。当字符指针与
%p格式说明符一起使用时,必须将其强制转换为非字符指针(例如void *)。
LOG_WRN("%s", str);
LOG_WRN("%p", (void *)str);
限制如下:
日志记录不支持带宽度限定符的字符串格式说明符(例如
%.*s或%8s)。这是因为构建日志消息时并不会使用格式字符串的内容,只使用参数类型。如果使用延迟日志记录,并且日志消息带有线程名称前缀(Kconfig 选项
CONFIG_LOG_THREAD_ID_PREFIX=y和CONFIG_THREAD_NAME=y),则会假定格式化日志消息时相应的k_thread结构仍然有效。当该结构是动态分配的(例如使用k_malloc()或malloc())时,这可能带来问题。在这种情况下,如果线程记录了一些消息后停止运行,并且其struct k_thread被释放,那么日志系统在稍后处理该消息时仍会尝试访问该结构。这会造成释放后使用的场景。为避免出现这种情况,一种解决办法是在释放该结构之前调用log_flush()。
struct k_thread *thread = k_malloc(sizeof(*thread)); /* struct allocated dynamically */
k_thread_create(thread, ...);
k_thread_name_set(thread, "foobar");

/* Thread calls LOG_*(...) */

k_thread_join(thread, K_FOREVER);
log_flush();  /* flush log buffer before freeing the struct k_thread */
k_free(thread); /* avoid a potential use-after-free scenario if deferred logging is used */
基准测试
以下基准测试数据来自在 qemu_x86 上运行的 tests/subsys/logging/log_benchmark。这是一项粗略的比较,旨在提供总体概况。
特性 |
|
|---|---|
内核日志记录 |
7us [3]/11us |
用户日志记录 |
13us |
带覆盖的内核日志记录 |
10us [3]/15us |
记录瞬态字符串 |
42us |
从用户上下文记录瞬态字符串 |
50us |
内存利用率 [4] |
518 |
内存占用(测试) [5] |
2k |
内存占用(应用) [6] |
3.5k |
消息占用 [7] |
47 [3]/32 字节 |
基准测试详情
栈使用情况
启用日志记录后,它会影响使用日志 API 的上下文的栈使用情况。如果对栈进行了优化,可能会导致栈溢出。栈使用情况取决于模式和优化设置,在不同平台之间也有显著差异。一般来说,使用 CONFIG_LOG_MODE_DEFERRED 时,栈使用情况更小,因为日志记录仅限于创建和存储日志消息。使用 CONFIG_LOG_MODE_IMMEDIATE 时,日志消息由后端处理,这包括字符串格式化。在该模式下,栈使用情况将取决于所使用的后端。
下面列出了部分平台针对带两个 integer 参数的日志消息的特征数据:
平台 |
延迟 |
延迟(无优化) |
立即 |
立即(无优化) |
|---|---|---|---|---|
ARM Cortex-M3 |
40 |
152 |
412 |
783 |
x86 |
12 |
224 |
388 |
796 |
riscv32 |
24 |
208 |
456 |
844 |
xtensa |
72 |
336 |
504 |
944 |
x86_64 |
32 |
528 |
1088 |
1440 |
使用 ARM Coresight STM 进行日志记录
关于在 NRF54H20 上使用 ARM Coresight STM 进行日志记录,请参见 使用 ARM Coresight STM 的多域日志。